
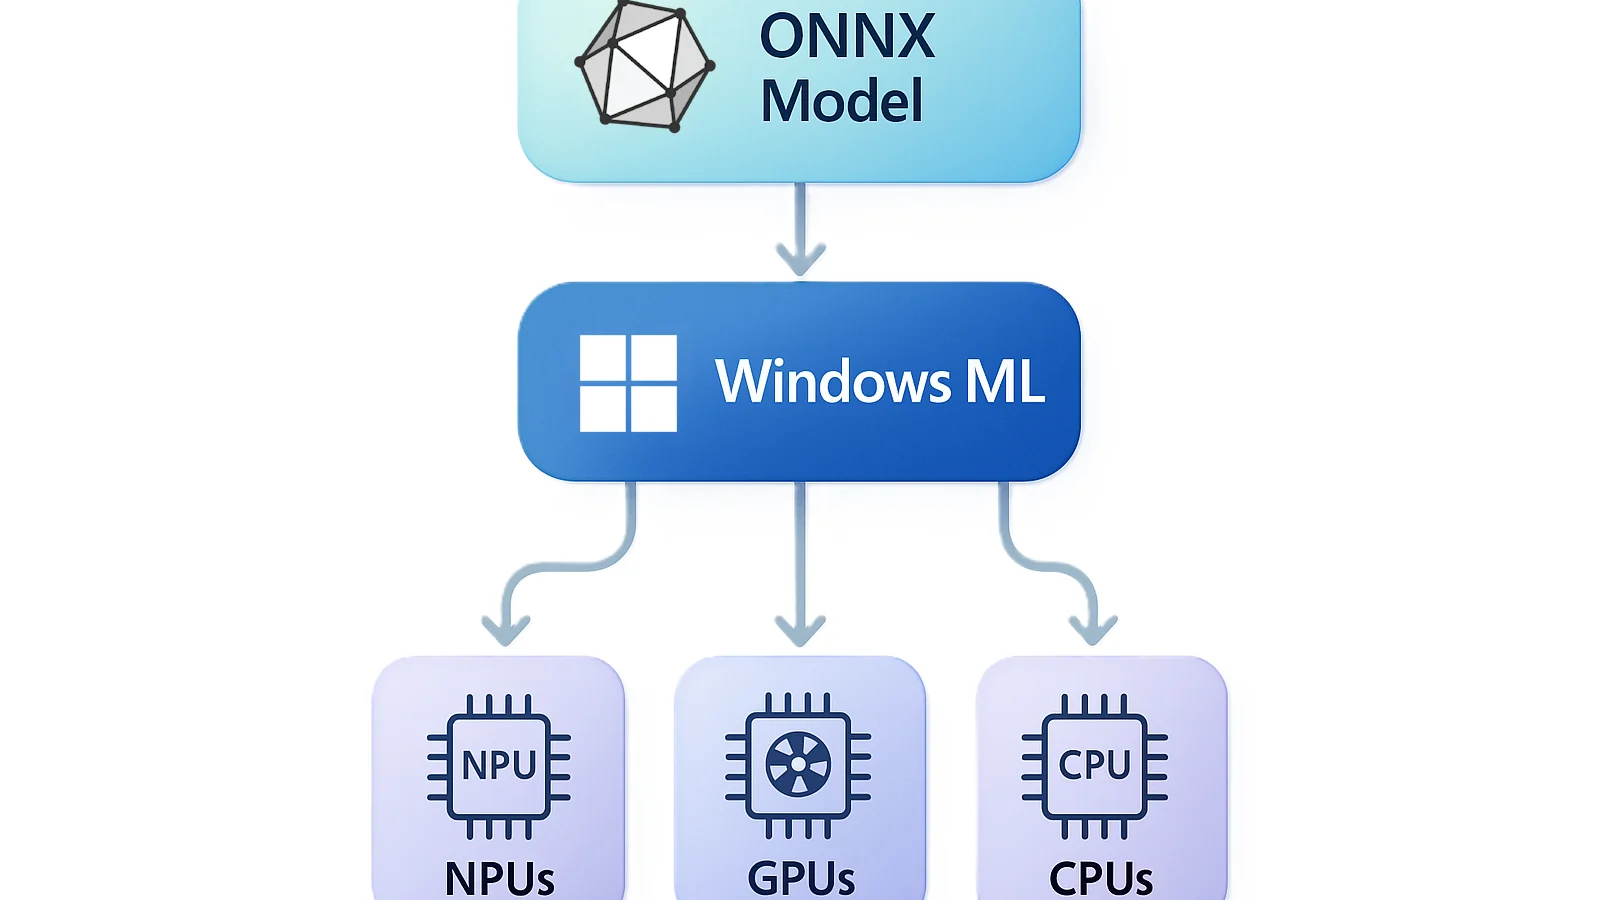
Microsoft ha incorporado a Windows ML una vía experimental para ejecutar modelos de lenguaje GGUF en el propio ordenador mediante llama.cpp. La novedad, anunciada el 7 de octubre, permite trabajar con modelos GGUF y ONNX desde una misma interfaz de generación de texto. Está dirigida a desarrolladores que quieran probar funciones de IA local en sus aplicaciones.
La restricción principal afecta a su distribución: Microsoft indica que las nuevas API Runtime y Text Generation no están admitidas para uso en producción y que las aplicaciones que las prueben no deben publicarse en Microsoft Store. Ambas están disponibles en C++ y Python; esta entrega todavía no ofrece soporte para C#.
Una interfaz común con distintos motores de ejecución
Text Generation API acepta los dos formatos, pero conserva un motor diferente para cada uno: llama.cpp ejecuta los archivos GGUF y ONNX Runtime se encarga de los modelos ONNX. No hay una conversión de GGUF a ONNX. La interfaz común permite acceder a ambos sin exigir que todos los modelos utilicen el mismo formato.
El soporte de hardware también tiene límites concretos. Microsoft valida la integración GGUF de llama.cpp en CPU y, opcionalmente, en GPU NVIDIA mediante CUDA. Esta vía no permite ejecutar GGUF en una NPU, el procesador dedicado a tareas de IA. Además, corresponde a la aplicación distribuir los módulos necesarios para utilizarla.
La elección del modelo queda en manos del desarrollador: Microsoft no incluye ninguno con Text Generation API. También debe encargarse de distribuirlo. GGUF incorpora el tokenizador, que transforma el texto en las unidades que procesa el modelo; los modelos ONNX necesitan uno separado y deben cumplir una estructura concreta de entradas, salidas y estado.
Pruebas locales, transcripción y controles limitados
Windows ML ofrece un servidor local con un punto de acceso compatible con la API de OpenAI. Esto permite probar modelos propios desde clientes que ya utilicen esa interfaz. Por debajo, Runtime API permite cargar modelos, elegir dónde se ejecutan y enlazar varias etapas de procesamiento. Las API existentes de ONNX Runtime siguen disponibles.
La primera entrega añade asimismo Speech Recognition API, que transcribe audio mediante un modelo Whisper en formato ONNX. Microsoft plantea combinar esa transcripción con la generación de texto, de modo que el resultado del reconocimiento de voz pueda alimentar la siguiente etapa.
Los controles de generación son todavía reducidos. Text Generation API solo expone decodificación voraz: en cada paso elige la siguiente unidad de texto con mayor probabilidad. No ofrece ajustes como temperature, top-p o top-k, utilizados para modificar la selección y variedad de las respuestas. Tampoco incorpora decodificación especulativa, plantillas de chat ni salida estructurada, funciones que quedan fuera de esta primera interfaz experimental.