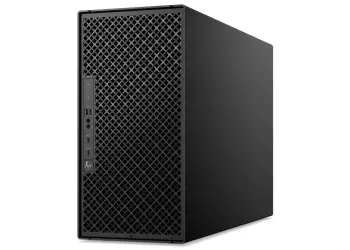


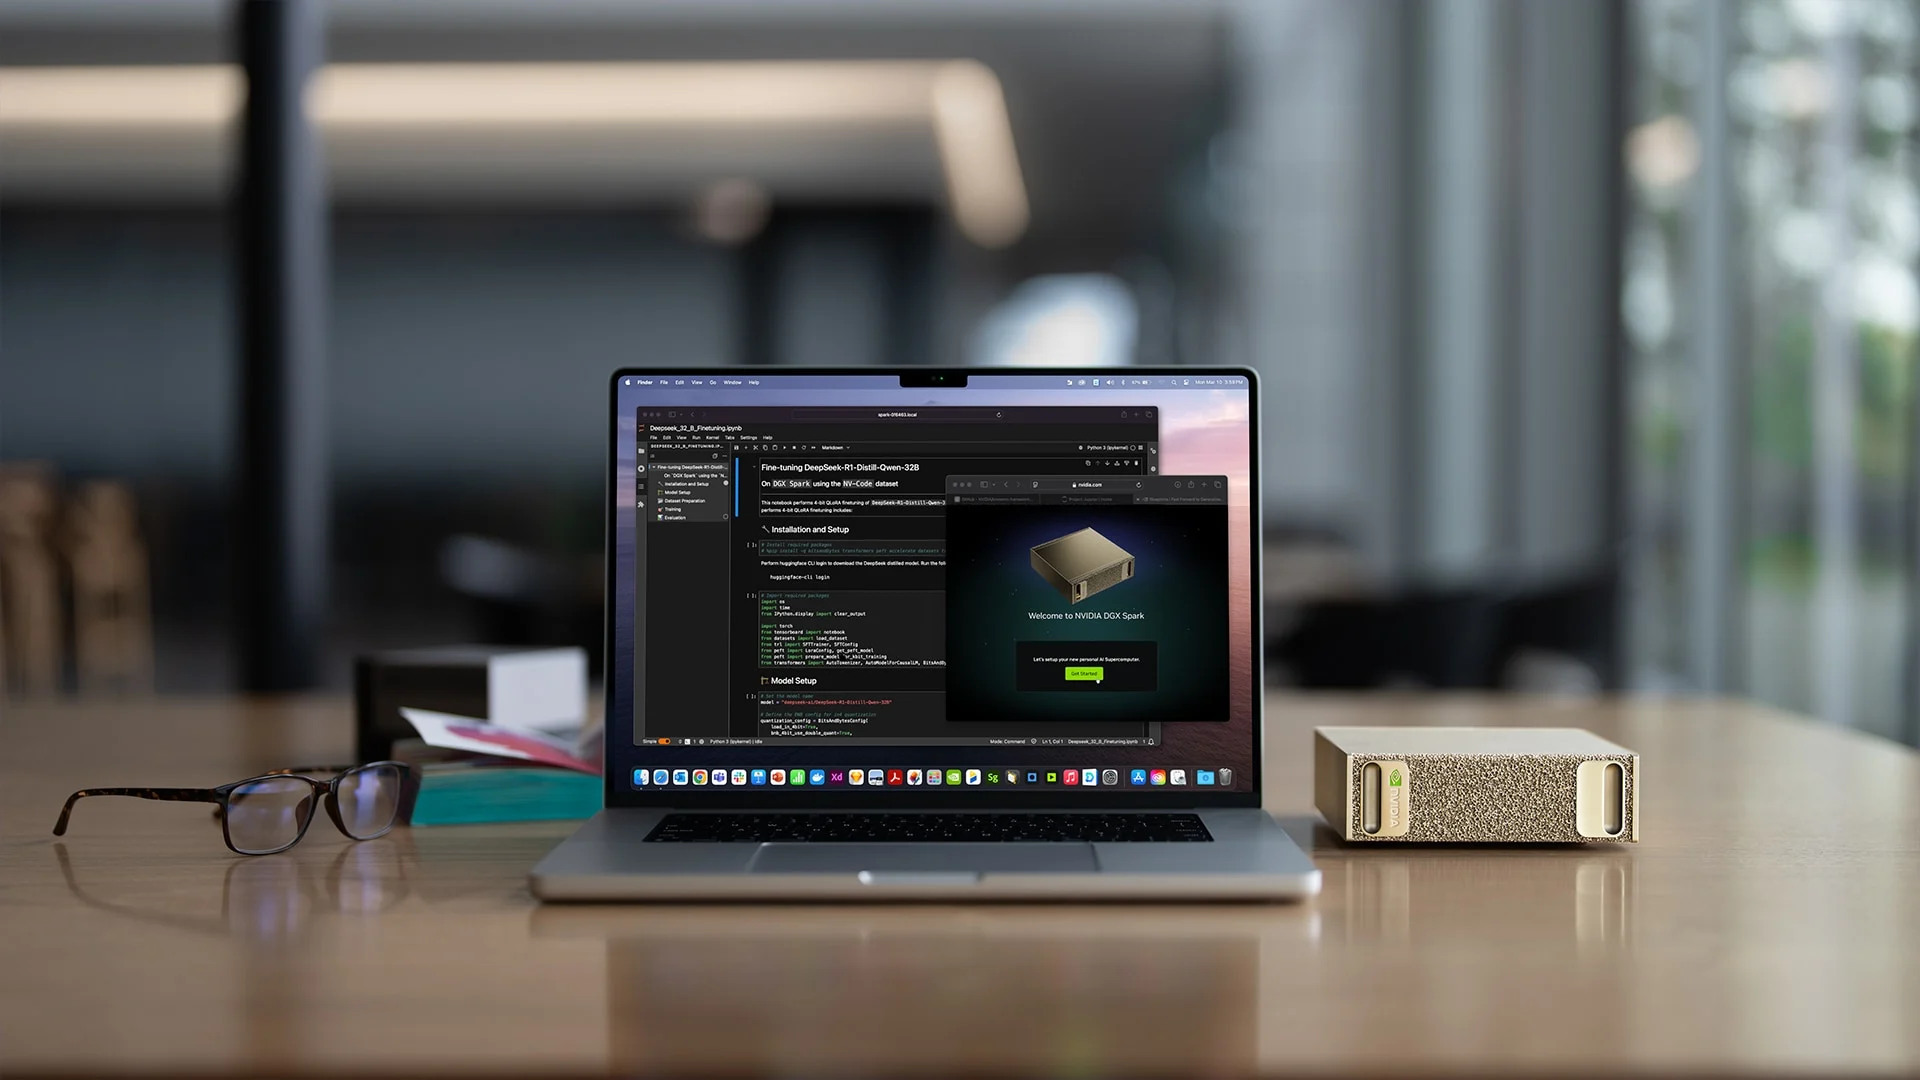
NVIDIA DGX Spark parece un mini PC, pero su planteamiento es muy distinto al de un ordenador doméstico. Dentro de una caja de 15 centímetros de lado reúne el superchip GB10 Grace Blackwell, 128 GB de memoria unificada y la pila de software de NVIDIA para ejecutar, ajustar y desplegar inteligencia artificial de forma local. Su público no es quien busca jugar o sustituir un sobremesa convencional, sino desarrolladores, investigadores y empresas que quieren trabajar con modelos grandes sin enviar cada consulta a la nube.
La propuesta tiene una virtud muy concreta: permite cargar modelos que no caben en una tarjeta gráfica de consumo. También exige aceptar varios compromisos. Su precio es elevado, utiliza arquitectura Arm y su velocidad al generar texto depende muchísimo del modelo, la cuantización y el programa empleado. Esta review analiza qué ofrece sobre el papel y qué rendimiento cabe esperar a partir de mediciones reproducibles publicadas por usuarios del equipo; no presentamos esos resultados como pruebas realizadas por UktusNas.
Un Grace Blackwell completo en una caja de 1,2 kilogramos
El corazón del DGX Spark es el GB10, que combina una CPU Arm de 20 núcleos —diez Cortex-X925 y diez Cortex-A725— con una GPU Blackwell de 6.144 núcleos CUDA y Tensor Cores de quinta generación. NVIDIA anuncia hasta 1 petaFLOP de cálculo de IA en FP4 con dispersión. Esa cifra describe un escenario de precisión muy baja y optimizado; no debe compararse directamente con los TFLOPS convencionales de una GPU.
Lo verdaderamente diferencial son sus 128 GB de LPDDR5X coherente y unificada. CPU y GPU comparten el mismo espacio de memoria, evitando depender de una VRAM separada mucho más pequeña. El ancho de banda alcanza 273 GB/s: es suficiente para alojar modelos enormes, aunque limita la velocidad de decodificación de los modelos densos frente a sistemas con memorias más rápidas.
| Componente | NVIDIA DGX Spark |
|---|---|
| Procesador | GB10 Grace Blackwell, CPU Arm de 20 núcleos |
| GPU | Blackwell, 6.144 CUDA Cores y Tensor Cores de 5.ª generación |
| Memoria | 128 GB LPDDR5X unificada, 273 GB/s |
| Almacenamiento | SSD NVMe M.2 autocifrado de 4 TB |
| Modelos | Inferencia hasta 200.000 millones de parámetros; ajuste hasta 70.000 millones |
| Red | Ethernet 10 Gb, Wi-Fi 7, Bluetooth 5.4 y ConnectX-7 |
| Conexiones | 4 USB-C, HDMI 2.1a y 2 QSFP de hasta 200 Gb/s cada uno |
| Dimensiones y peso | 150 × 150 × 50,5 mm; 1,2 kg |
| Alimentación | Fuente externa de 240 W; TDP de 140 W para el GB10 |
Consumo contenido para la memoria que ofrece
La fuente incluida entrega 240 W y NVIDIA fija en 140 W el TDP del SoC. Los 100 W restantes cubren memoria, SSD, red, periféricos y demás componentes; eso no significa que el equipo consuma siempre 240 W en el enchufe. NVIDIA no publica una cifra oficial de reposo ni una media para inferencia, por lo que sería engañoso convertir la potencia de la fuente en consumo real.
Aun así, el techo eléctrico es moderado para un sistema capaz de alojar 128 GB de memoria acelerada y modelos de más de 100.000 millones de parámetros. Su ventaja energética está en concentrar una estación completa de IA en menos de 240 W, no necesariamente en batir a cualquier GPU en rendimiento por vatio para modelos pequeños.
Cuántos tokens por segundo puede generar con LM Studio
La cifra cambia de forma radical según la arquitectura del modelo. Una medición comunitaria sobre un equipo GB10 equivalente al DGX Spark utilizó LM Studio 4.7, CUDA 13 y llama.cpp para Linux Arm, cargando el contexto completo y promediando tres respuestas. No es una prueba de laboratorio uniforme ni representa el máximo posible con vLLM o TensorRT-LLM, pero sirve para entender el orden de magnitud.
| Modelo | Formato | Parámetros | Generación |
|---|---|---|---|
| Qwen 2.5 | Q3_K_M | 7B | 45,13 tokens/s |
| Qwen3 Coder A3B Instruct | Q8_0 | 30B | 52,76 tokens/s |
| Qwen 3.5 A3B | BF16 | 35B | 27,70 tokens/s |
| Qwen3 Coder Next | Q6_K | 80B | 44,15 tokens/s |
| GPT-OSS A5B | Q4_K_S | 120B | 48,96 tokens/s |
| Qwen 3.5 | Q4_K_M | 122B | 24,20 tokens/s |
| Llama 3.3 | Q5_K_M | 70B | 3,95 tokens/s |
La aparente paradoja de que algunos modelos de 80B o 120B superen a uno de 70B se explica por las arquitecturas Mixture of Experts: tienen muchos parámetros totales, pero activan solo una fracción por token. En los modelos densos, cada token obliga a recorrer una parte mucho mayor de los pesos y los 273 GB/s de memoria se convierten en el cuello de botella.
Para conversar, programar o usar un agente, entre 20 y 50 tokens por segundo ofrece una respuesta fluida. Alrededor de 4 tokens por segundo sigue siendo utilizable para tareas largas y desatendidas, pero resulta lento en una conversación. La gran baza del Spark es la capacidad y el ecosistema CUDA, no ganar todas las comparativas de velocidad bruta.
Qué se puede hacer con un DGX Spark
Es posible montar un asistente privado similar a ChatGPT mediante LM Studio, Ollama, llama.cpp o servidores optimizados. No ejecuta el ChatGPT comercial ni los modelos cerrados de OpenAI: ejecuta modelos abiertos compatibles y permite mantener conversaciones, documentos y bases de conocimiento dentro de la red local.
También puede actuar como cerebro de un agente que consulte archivos, escriba código, use herramientas o automatice procesos. La memoria facilita combinar un modelo grande con contexto amplio, embeddings y otros servicios sin repartirlos entre varias máquinas. La integración con CUDA, PyTorch, TensorRT-LLM, NVIDIA NIM y contenedores facilita pasar de un experimento a una API local.
Para programación, un modelo especializado puede integrarse con un editor, revisar repositorios, generar pruebas o ejecutar tareas dentro de un entorno controlado. NVIDIA está reforzando precisamente este terreno con sus modelos y herramientas para agentes, como las novedades de Nemotron y NeMo Switchyard. Otros usos incluyen ajuste LoRA de modelos de hasta 70B, visión artificial, robótica, ciencia de datos, generación de imágenes y prototipos que después se despliegan en un centro de datos.
Dos DGX Spark en clúster: más memoria, no magia
Cada unidad incorpora dos puertos QSFP conectados a una NIC ConnectX-7, con hasta 200 Gb/s por puerto. NVIDIA documenta la conexión directa de dos equipos mediante cable compatible y ofrece procedimientos para agrupaciones mayores a través de red. Con dos unidades, la plataforma puede abordar modelos de hasta 405.000 millones de parámetros.
El clúster sirve principalmente para repartir un modelo que no cabe en 128 GB. No garantiza duplicar los tokens por segundo: hay que fragmentar los pesos, sincronizar nodos y pagar la latencia de comunicación. Para atender varias peticiones simultáneas también puede resultar más eficiente dedicar modelos o réplicas diferentes a cada equipo.
Precio y valoración: una herramienta profesional muy específica
NVIDIA muestra el DGX Spark de 4 TB por 4.800 euros en su tienda europea, aunque aparece sin existencias en el momento de redactar esta review. En una tienda española figura por 5.509 euros y sin fecha exacta de entrada. Un clúster de dos unidades parte, por tanto, de unos 9.600 euros al precio oficial, antes del cableado y de posibles diferencias del distribuidor.
No es una compra racional para usar modelos de 7B o 14B: una GPU de consumo potente puede ofrecer más velocidad por mucho menos dinero. El cálculo cambia cuando el proyecto necesita 128 GB de memoria accesible por la GPU, modelos de 70B a 200B, arquitectura CUDA, funcionamiento permanente y un escritorio silencioso y compacto.
El veredicto depende menos del petaFLOP promocional que de esa memoria. DGX Spark es una estación de desarrollo de IA excepcionalmente compacta, pero no un acelerador universal. Para crear un asistente local avanzado, experimentar con agentes, programar con modelos grandes o validar un despliegue profesional tiene mucho sentido; para obtener la mayor cifra de tokens por euro con modelos pequeños, existen alternativas claramente más económicas.