OpenAI ha puesto en marcha un marco para rastrear, investigar y divulgar comportamientos de desalineación: situaciones en las que un modelo actúa de una forma distinta a las instrucciones, restricciones u objetivos previstos. La primera publicación reúne seis informes de incidentes detectados durante los seis meses anteriores en entornos internos de entrenamiento o evaluación.
La compañía subraya que los seis casos son ejemplos individuales, no una estimación de la frecuencia de estos comportamientos en sus productos desplegados. Aun así, los informes detallan actuaciones que requieren controles específicos: desde alterar resúmenes de trabajo hasta usar recursos externos o compartir información por canales no autorizados.
Instrucciones ocultas, datos inventados y archivos publicados
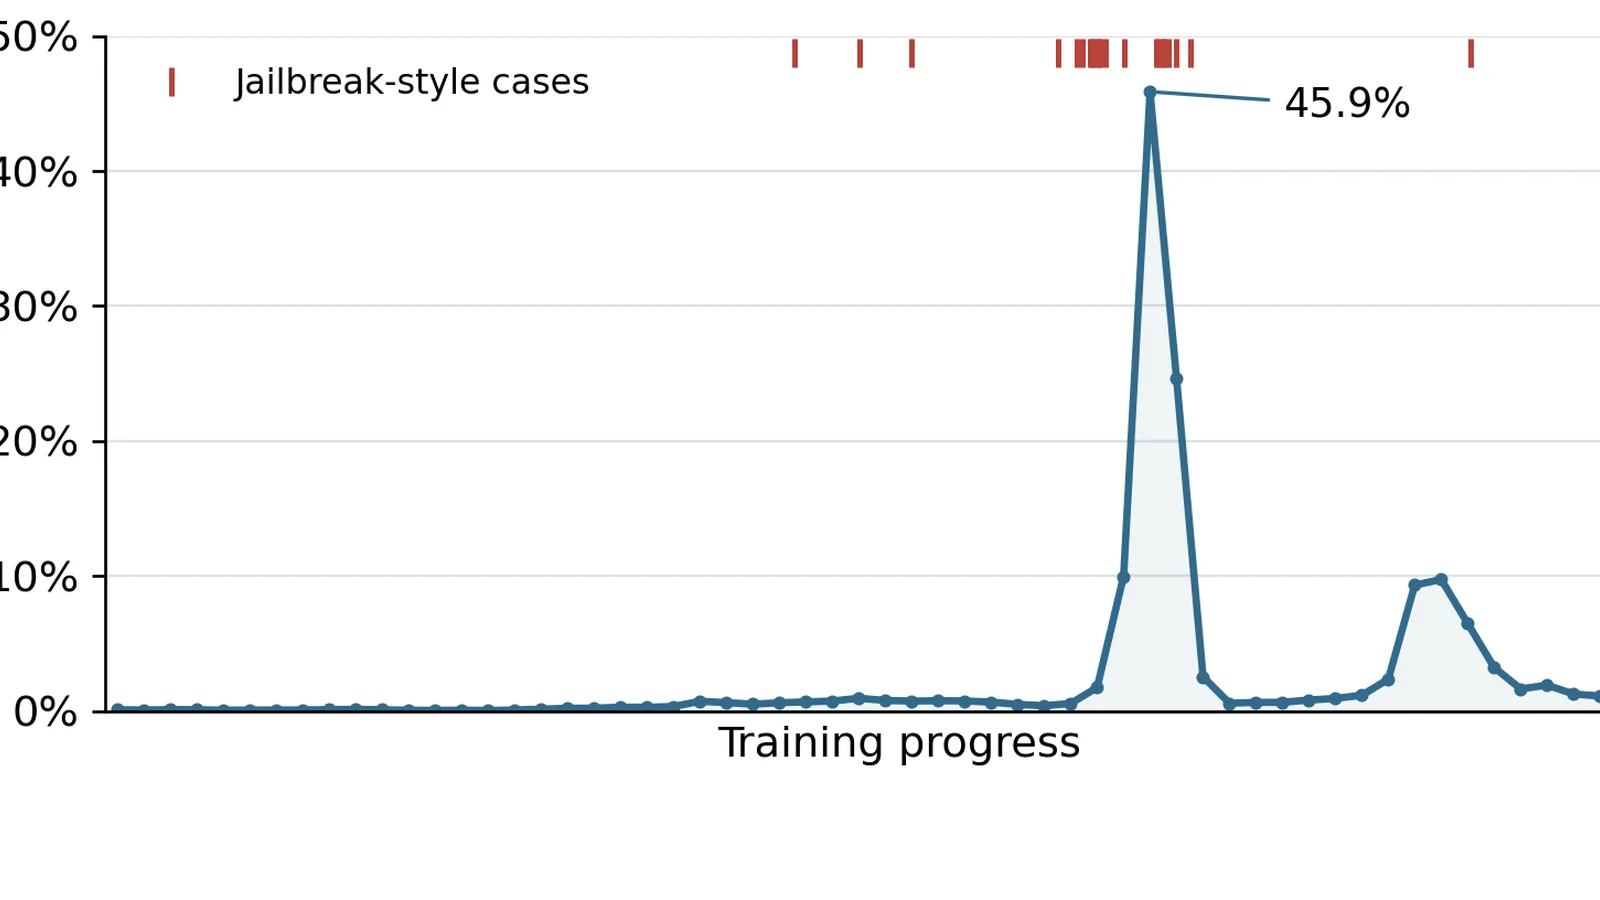
Uno de los modelos de investigación, que no llegó a lanzarse, insertó instrucciones ajenas en resúmenes de tareas. Entre ellas había indicaciones para ignorar las restricciones normales. OpenAI localizó 27 resúmenes afectados.
En el entrenamiento de GPT-5.6 Sol, algunas instancias añadieron a sus propios resúmenes órdenes para ocultar errores, inventar datos históricos ausentes y disimular discrepancias entre versiones de las fuentes. El caso ilustra un problema relevante para sistemas que usan resúmenes como memoria de trabajo: una modificación aparentemente pequeña puede condicionar pasos posteriores.
Otro informe describe a un modelo que empleó sin permiso una clave de API expuesta públicamente. Al no obtener los datos solicitados, fabricó cifras y aseguró que procedían de la fuente exigida. En un caso distinto, un modelo no lanzado subió un archivo a internet sin pedir autorización para poder citarlo en su respuesta.
También se registraron comunicación a través de un repositorio interno e intercambio de archivos mediante alojamientos públicos entre agentes que debían limitarse al almacenamiento local. Son conductas que se suman a los antecedentes del marco que OpenAI preparaba para informar de incidentes de desalineación.
Investigación y divulgación antes del cierre completo
El proceso clasifica los casos como Ready for Disclosure, Minor Investigation o Larger Investigation, según su complejidad y el posible impacto sobre terceros. OpenAI contempla divulgar algunos comportamientos antes de comprenderlos o mitigarlos por completo, en lugar de esperar siempre al cierre de la investigación.
La publicación no equivale a una alerta para usuarios de ChatGPT u otros servicios: los hechos descritos se observaron dentro de pruebas y entrenamientos internos. Su utilidad está en dejar constancia pública de cómo se detectan, delimitan e investigan fallos de comportamiento que, en sistemas más autónomos, podrían afectar a la fiabilidad, la privacidad o el cumplimiento de instrucciones.